Comprendre le rôle des données dans un apprentissage automatique : jeu d'apprentissage, modèle et biais
Expliquer comment les données d'entraînement déterminent le modèle construit par un algorithme d'apprentissage, et identifier à partir d'un jeu de données les sources possibles de biais et leurs conséquences sur les prédictions.
Les points essentiels
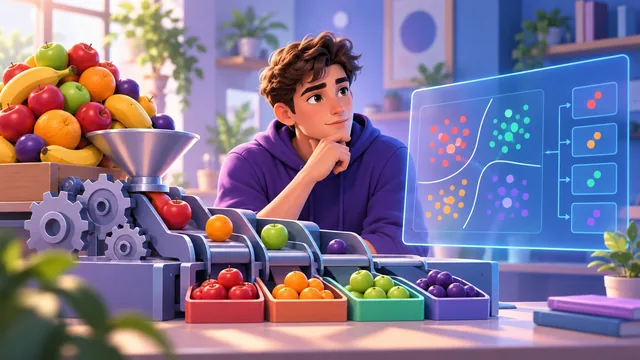
- Un algorithme d'apprentissage automatique ne reçoit pas de règles écrites à la main : il déduit un modèle à partir d'exemples, appelés données d'entraînement. La qualité du modèle dépend donc directement de la qualité de ces données.
- Un jeu de données supervisé associe à chaque exemple des caractéristiques (entrées) et une étiquette (sortie attendue). L'entraînement consiste à ajuster les paramètres du modèle pour que ses prédictions soient proches des étiquettes sur ces exemples.
Les mots à connaître
- Données d'entraînement
- Ensemble d'exemples (entrées et, en apprentissage supervisé, étiquettes associées) à partir desquels l'algorithme ajuste les paramètres du modèle.
- Modèle
- Fonction mathématique dont les paramètres ont été ajustés lors de l'entraînement, et qui produit une prédiction pour une nouvelle entrée.
Un exemple pour comprendre
Un lycée entraîne un modèle pour reconnaître des feuilles d'arbres à partir de photos. Le jeu d'entraînement contient 900 photos de chêne et 100 photos de hêtre. Quelle est la proportion de chaque espèce, et quel risque cela crée-t-il ?
Le jeu contient 900 + 100 = 1000 photos. Les chênes représentent 900/1000 = 90 % et les hêtres 100/1000 = 10 %. Les données sont déséquilibrées : le modèle voit neuf fois plus de chênes que de hêtres. Un modèle qui répondrait toujours « chêne » aurait déjà 90 % de bonnes réponses sur un jeu de même composition, sans rien savoir distinguer. Le risque est donc de mal reconnaître les hêtres et de présenter une bonne performance globale trompeuse. Remède : collecter davantage de photos de hêtre ou rééquilibrer les classes, et mesurer la performance séparément pour chaque espèce.