Découvrir la recherche textuelle : chercher un motif dans un texte
Expliquer le problème de la recherche d'un motif dans un texte, décrire l'algorithme naïf par comparaisons successives et justifier pourquoi un automate fini permet d'éviter des comparaisons répétées.
Les points essentiels
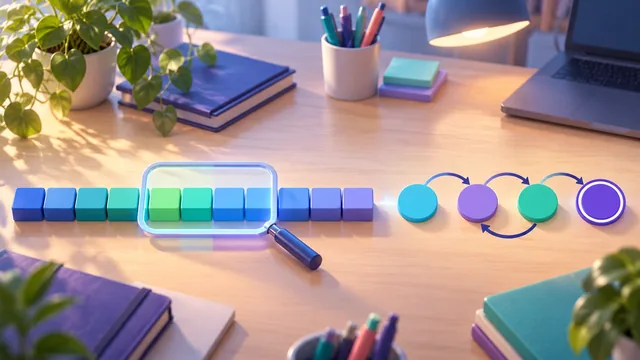
- La recherche textuelle consiste à déterminer si un motif (chaîne de longueur m) apparaît dans un texte (chaîne de longueur n) et, si oui, à quelle position (indice du premier caractère de l'occurrence).
- Le motif et le texte sont des mots sur un même alphabet fini (lettres, chiffres, bases A, C, G, T d'un brin d'ADN...). Les positions se comptent à partir de 0 avec les indices Python.
Les mots à connaître
- Motif
- Chaîne de caractères de longueur m que l'on cherche dans un texte plus long. Une occurrence du motif en position i signifie que texte[i:i+m] est égal au motif.
- Recherche textuelle
- Problème algorithmique : étant donné un texte de longueur n et un motif de longueur m, déterminer s'il existe au moins une occurrence du motif et, selon l'énoncé, renvoyer la première position, toutes les positions ou leur nombre.
Un exemple pour comprendre
Avec l'algorithme naïf, recherchez le motif « ABA » dans le texte « CABABA » (indices à partir de 0). Donnez toutes les positions d'occurrence et le nombre total de comparaisons de caractères.
Texte : C A B A B A (indices 0 à 5), motif ABA (m = 3), n = 6, donc positions testées : i = 0, 1, 2, 3. i = 0 : on compare 'C' et 'A' : différent, 1 comparaison. i = 1 : 'A'='A' (ok), 'B'='B' (ok), 'A'='A' (ok) : motif trouvé en position 1, 3 comparaisons. i = 2 : 'B' contre 'A' : différent, 1 comparaison. i = 3 : 'A'='A', 'B'='B', 'A'='A' : occurrence en position 3, 3 comparaisons. Bilan : occurrences aux positions 1 et 3 (elles se chevauchent sur le A de l'indice 3), total 1 + 3 + 1 + 3 = 8 comparaisons.